N° 07 ·
Comment j'ai mis mon SaaS en ligne, de A à Z
Data engineer. Je construis des trucs en solo et j'écris ce que ça donne — un mail par semaine, le mardi.
Salut, c’est Vincent.
Si tu viens d’arriver : je fais un challenge, une vidéo par jour pendant 100 jours, et aujourd’hui c’est le jour 85.
Ce mail est long, je te préviens. Pas de skill cette semaine : je t’ouvre le capot de mon SaaS.
Il s’appelle Nadia. C’est l’outil avec lequel je publie mes vidéos sur Instagram et TikTok, je réponds aux commentaires et je mesure ce qui marche. Chaque vidéo du challenge passe par lui. Et hier, pour mes 35 ans, il était prêt.
Où j’en suis, sans filtre : pré-lancement, 0 € de revenu récurrent. Le principal utilisateur, c’est moi. Quelques potes ont un accès, quelques clients en bêta vont sûrement payer, mais rien n’est signé.
Donc ce mail, ce n’est pas « comment j’ai réussi ». C’est comment on met un SaaS en ligne, de A à Z, et ce que ça coûte. Les liens sont à la fin.
Dis-moi ce que tu en penses en répondant à ce mail.
Ce que fait Nadia
Nadia, c’est une application web, usenadia.com. Tu connectes tes comptes Instagram et TikTok, et ensuite :
- tu programmes tes posts dans un calendrier, et Nadia les publie à l’heure dite ;
- tu lis tes commentaires et tes DM dans une boîte de réception, sans ouvrir les apps ;
- tu poses une automatisation sur une publication : quelqu’un commente un mot, il reçoit un DM avec ton lien. Chaque « commente SUPABASE et je t’envoie le lien » du challenge passe par là ;
- tu vois les chiffres de chaque vidéo, collectés tous les jours ;
- et tout ça se pilote par un agent, j’y viens juste après.
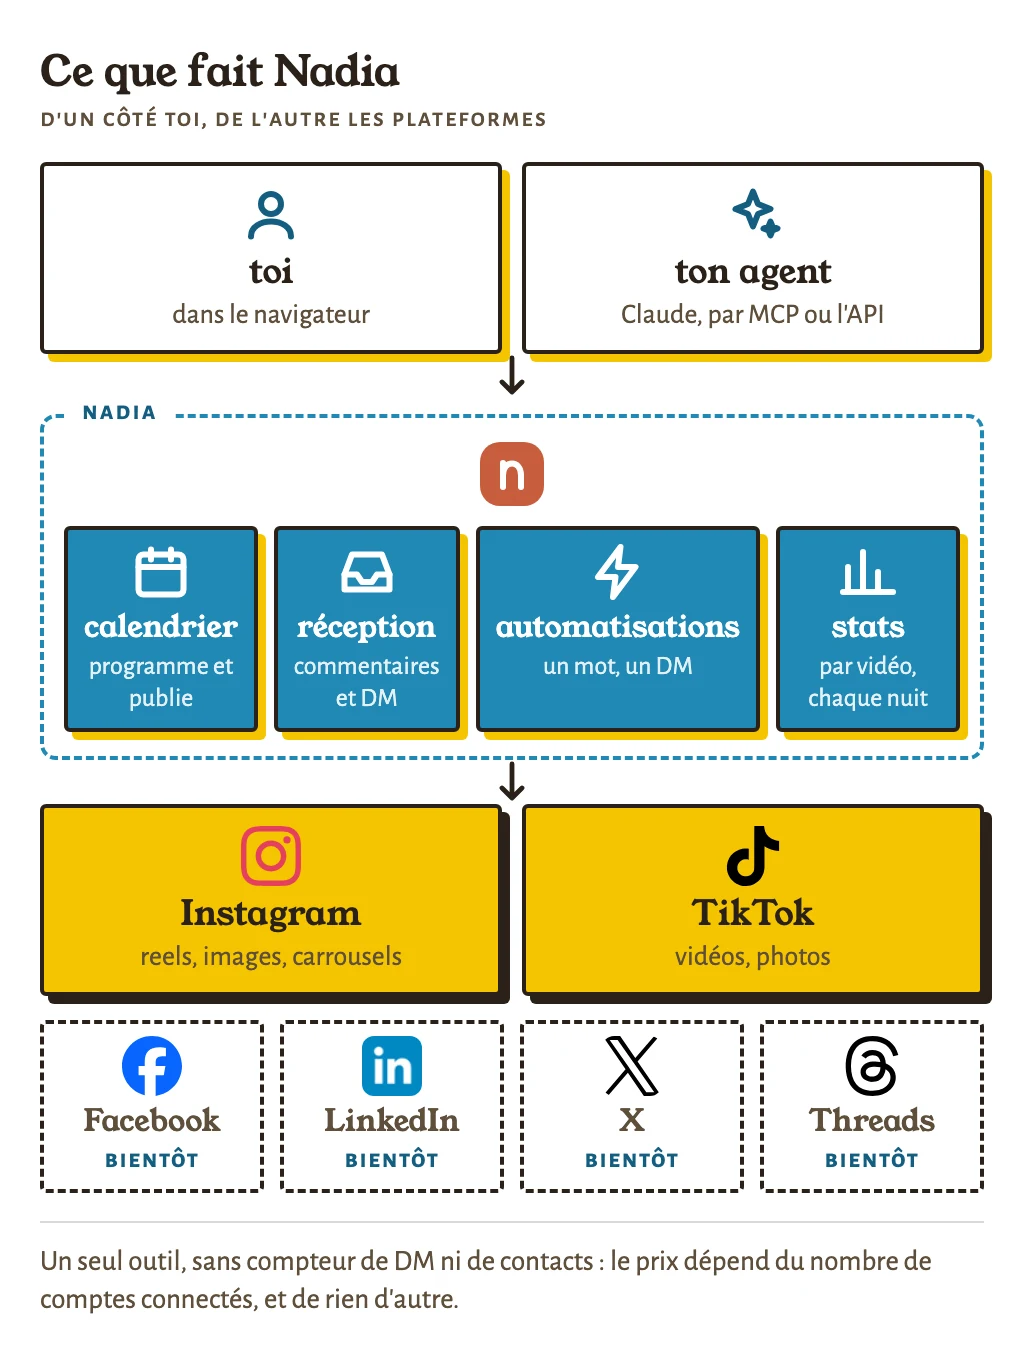
Si tu connais le marché : c’est Metricool pour programmer et mesurer, plus ManyChat pour les DM automatiques, plus un agent qui pilote le tout, dans un seul outil et un seul abonnement, sans compteur de DM.
Le côté agent, c’est le cœur
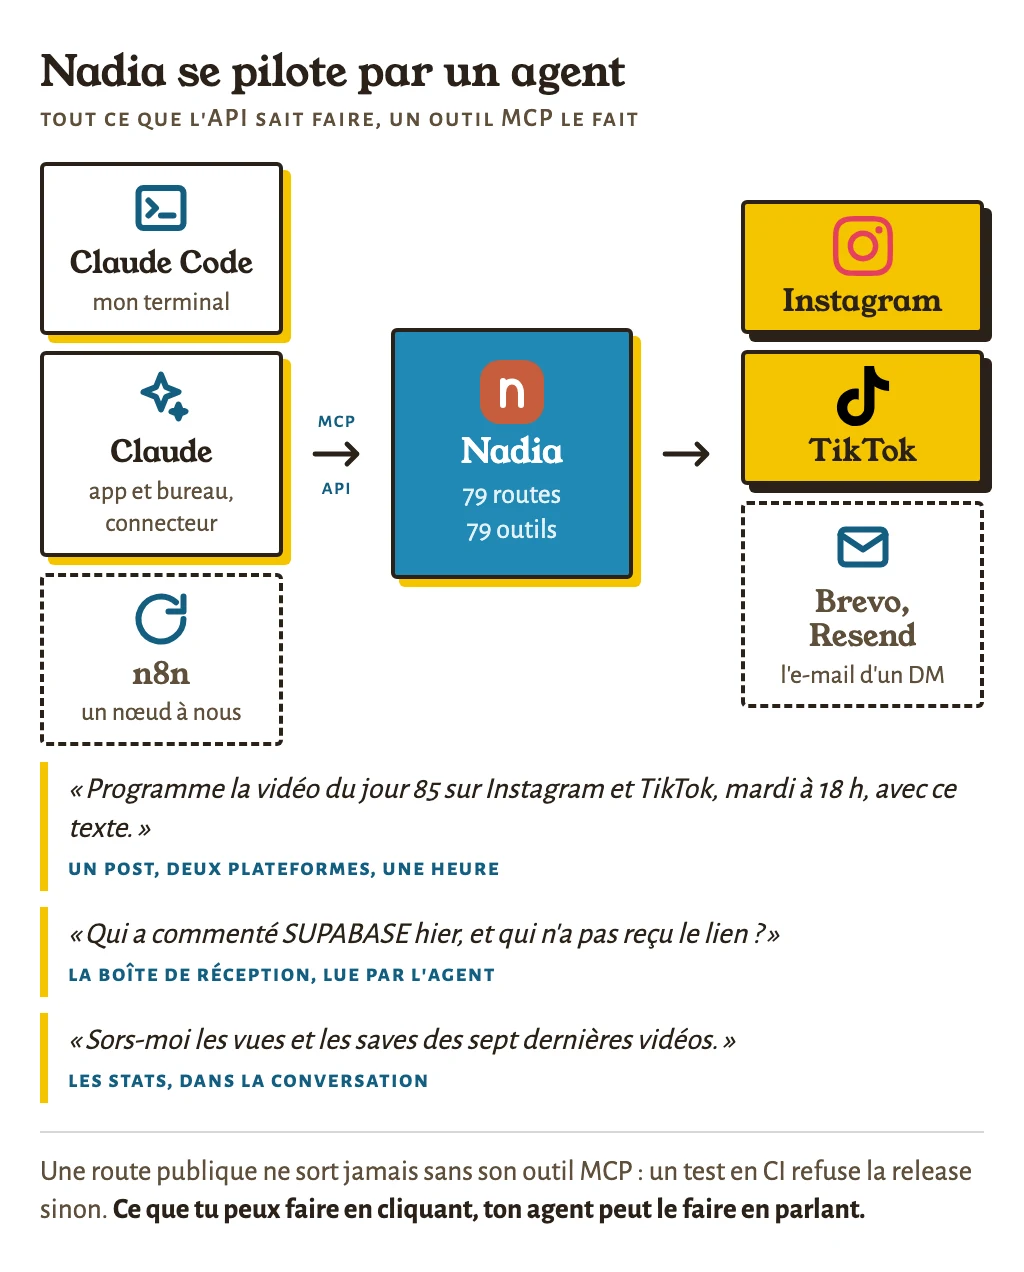
Nadia est agent-first. Tout ce que l’API publique sait faire, un outil MCP le fait aussi, et un test en CI refuse la release si une route sort sans son outil. Concrètement : tu branches Nadia comme connecteur dans Claude, ou dans Claude Code en une ligne, et tu lui parles. « Programme la vidéo du jour sur Instagram et TikTok à 18 h. » « Qui a commenté SUPABASE hier ? » « Sors-moi les vues des sept dernières vidéos. » Il y a aussi un nœud n8n et une ligne de commande pour ceux qui préfèrent.
C’est comme ça que je l’utilise tous les jours : ma chaîne de montage dépose la vidéo, et c’est Claude Code qui programme le post, pose l’automatisation et relit les commentaires. Ce que tu peux faire en cliquant, ton agent peut le faire en parlant.
Comment je l’ai construit
Nadia est en ligne depuis la mi-juillet, sur un seul serveur. Le premier post est parti le 18 juillet, et il y en a eu 211 depuis. Il a grossi avec le challenge : chaque fois qu’il me manquait quelque chose pour publier, répondre ou mesurer, je l’ai ajouté. Depuis juillet, 601 commits et 60 pull requests, dont une bonne partie écrites par des sessions Claude Code dans le cloud pendant que je tournais. Dans l’ordre : le calendrier et la publication, la boîte de réception, les automatisations commentaire vers DM, les stats par vidéo, et le serveur MCP pour que Claude publie à ma place.
L’architecture, pièce par pièce
Cinq pièces, et chacune a une raison d’exister.
Le frontend, en Next.js. L’interface : le calendrier, le composeur, la boîte de réception. Il ne décide rien, il appelle l’API.
Le backend, en NestJS. L’API. Il reçoit « programme ce post mardi à 10 h », vérifie que tu as le droit, l’écrit en base et passe la main au worker. Il porte aussi l’API publique et le serveur MCP : 79 routes, chacune doublée d’un outil MCP.
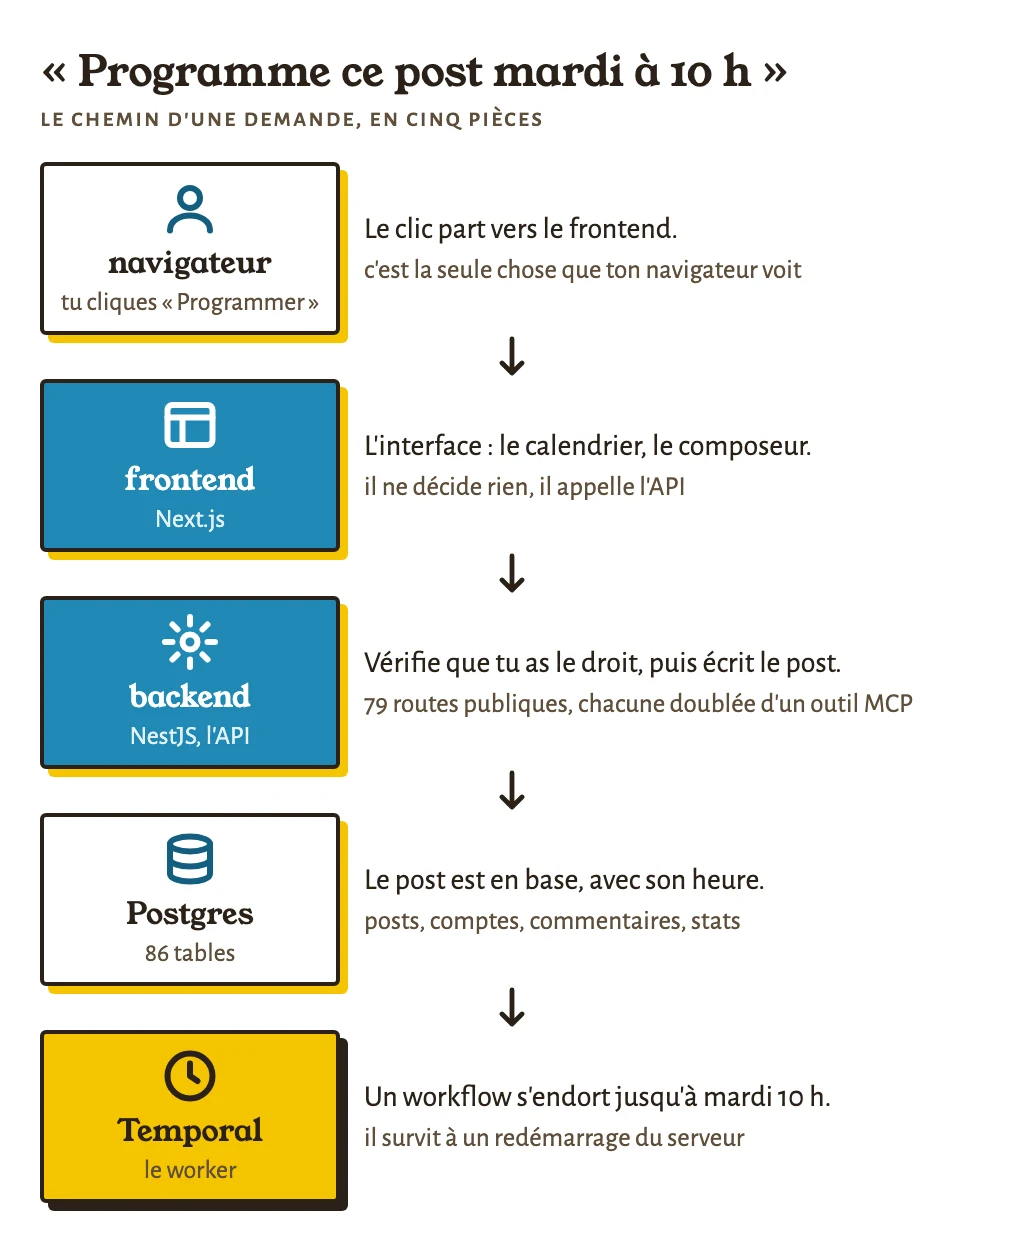
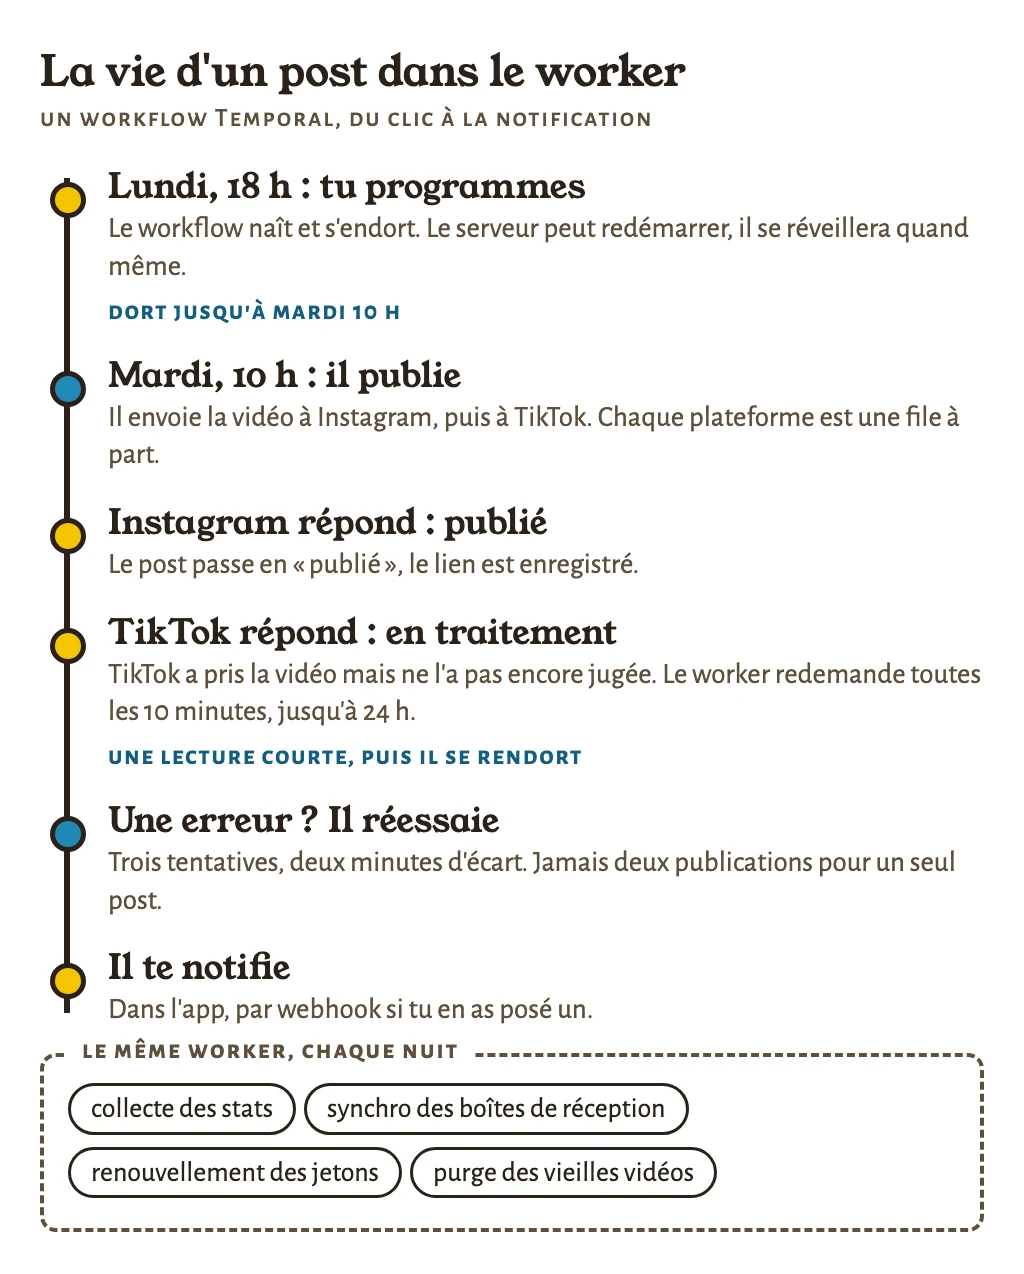
Le worker, avec Temporal. La pièce que la plupart des gens découvrent trop tard. Un post programmé pour mardi doit partir mardi, même si le serveur a redémarré lundi. Une vidéo envoyée à TikTok n’est pas publiée tout de suite, il faut lui redemander pendant vingt minutes. Et si Instagram répond une erreur, il faut réessayer, sans publier deux fois. Temporal fait exactement ça : chaque post est un workflow qui survit aux redémarrages, dort jusqu’à l’heure, et réessaie selon les règles que tu écris. Le même worker lance chaque nuit la collecte des stats, la synchro des boîtes de réception et le renouvellement des jetons.
Postgres, la base : 86 tables. Redis, pour le rapide et le jetable : sessions, verrous, files. Et à côté, le stockage des vidéos, qui a failli tout casser, j’y reviens.
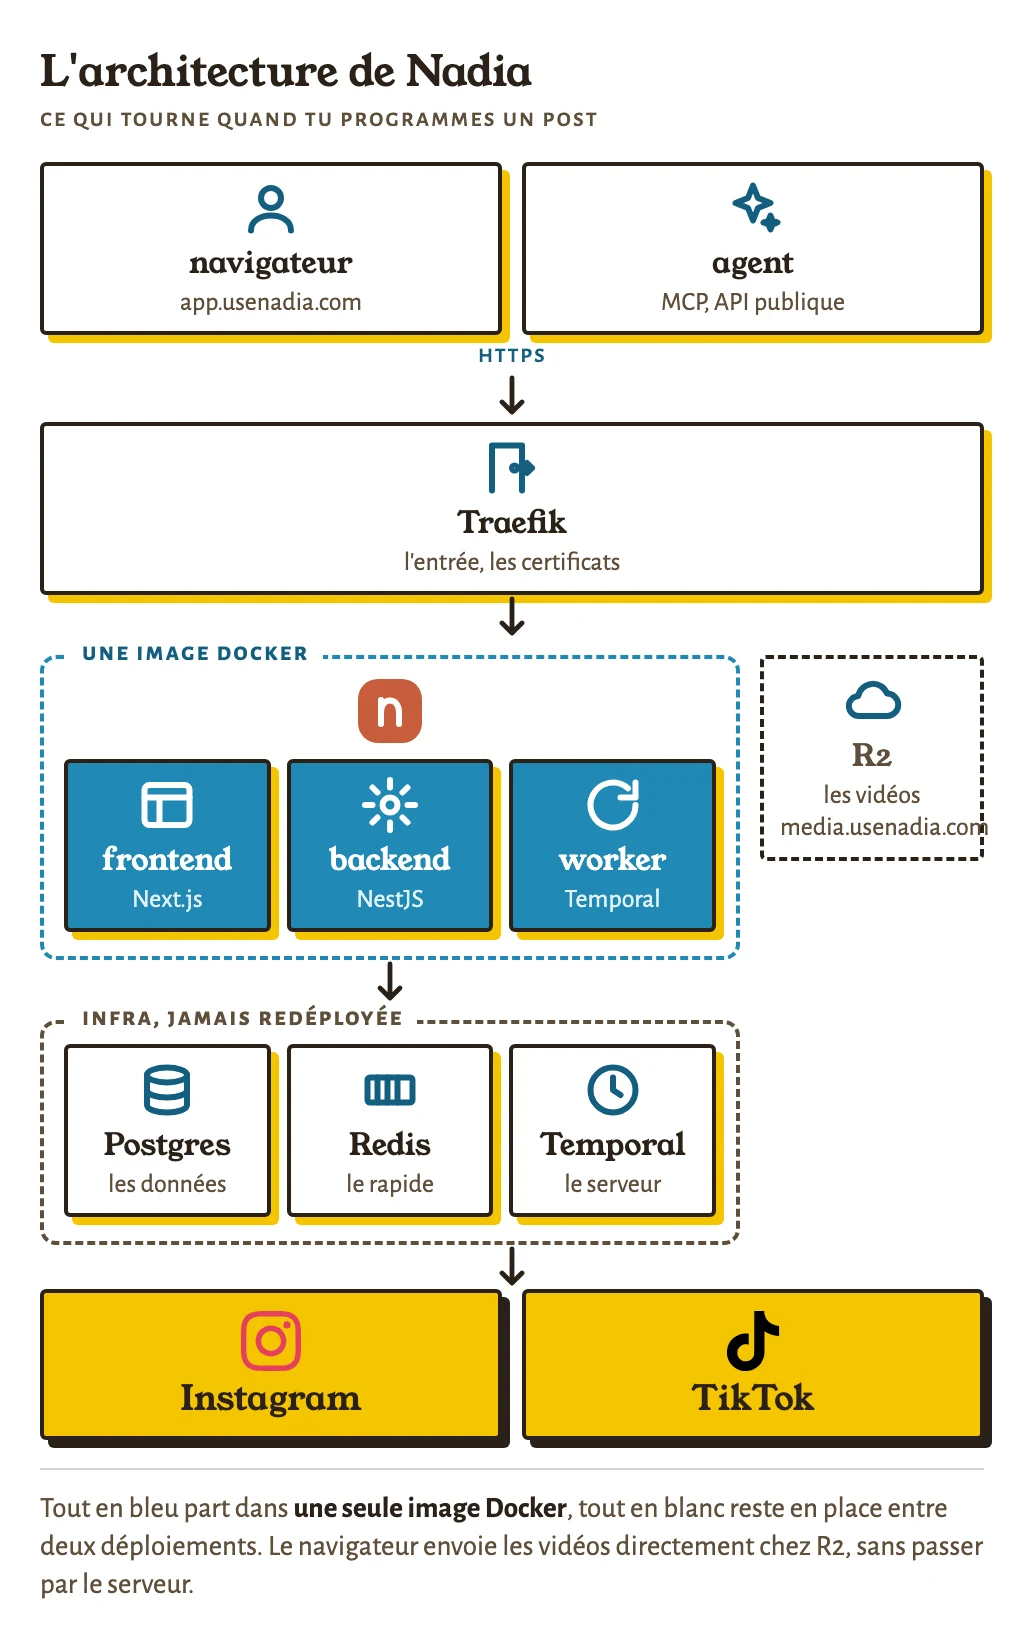
Les trois applications sont dans un seul monorepo et partent en production dans une seule image Docker. Moins propre qu’une image par service, et très bien pour un seul serveur.
Le serveur
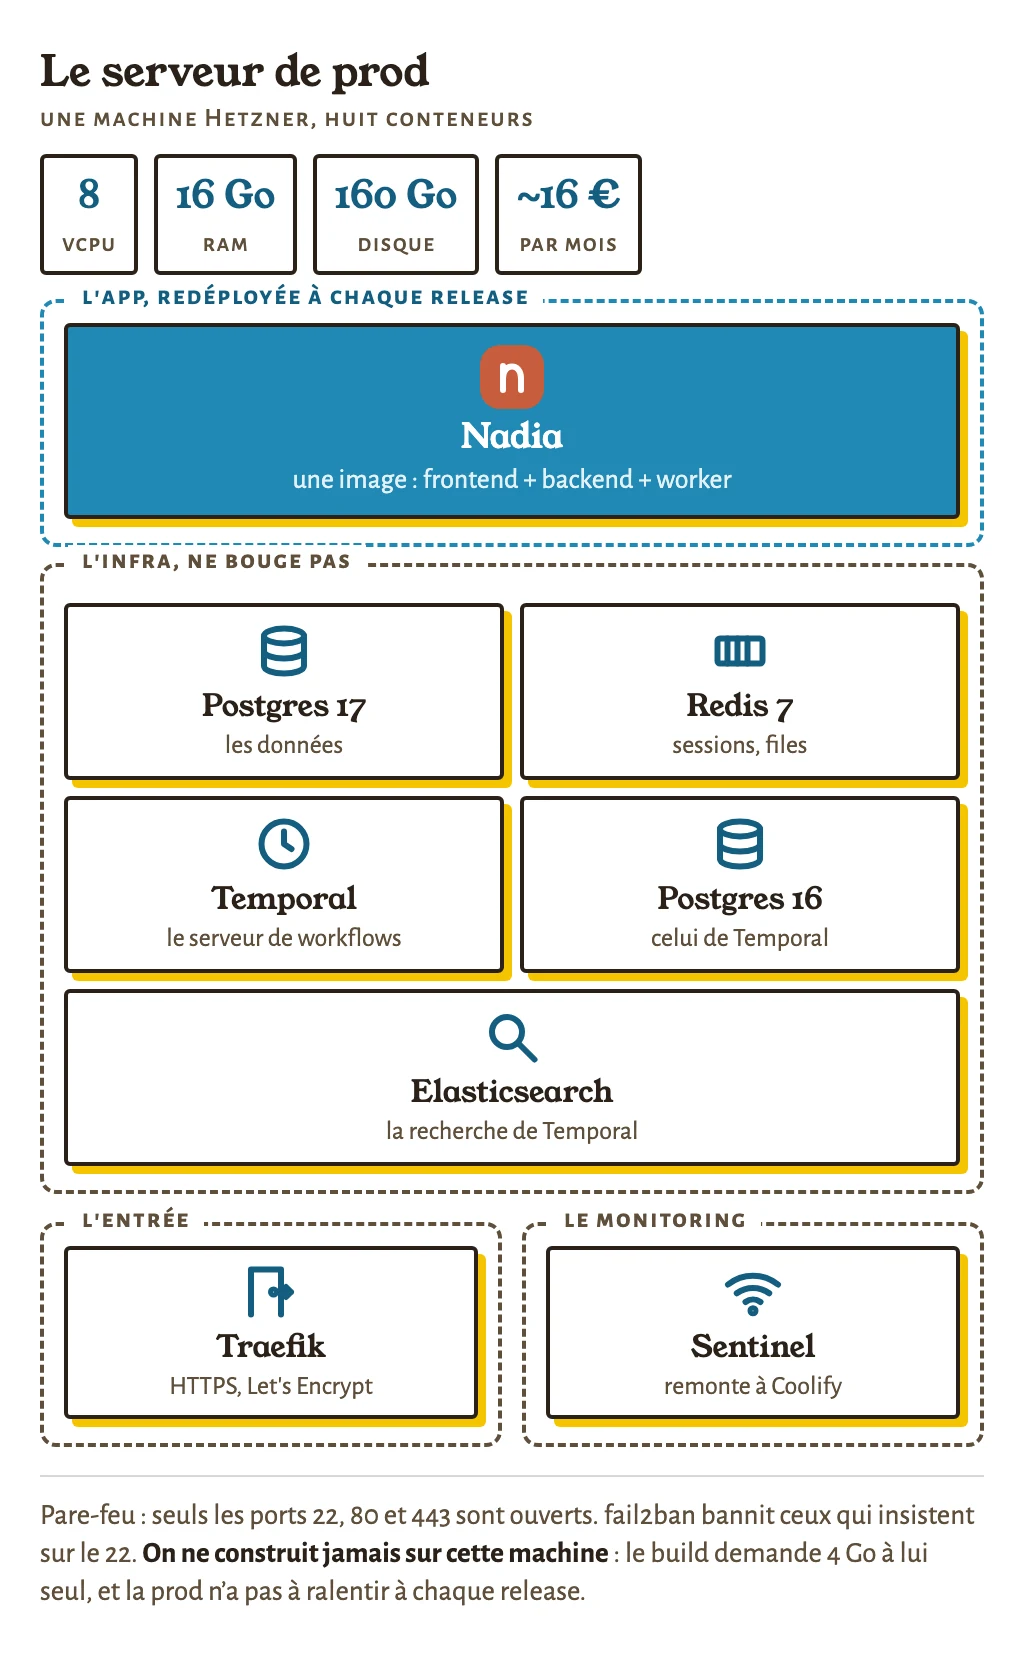
Une seule machine chez Hetzner : 8 vCPU, 16 Go de RAM, 160 Go de disque, autour de 16 € par mois. Un pare-feu qui ne laisse passer que SSH, HTTP et HTTPS, et fail2ban pour ceux qui insistent sur le port 22.
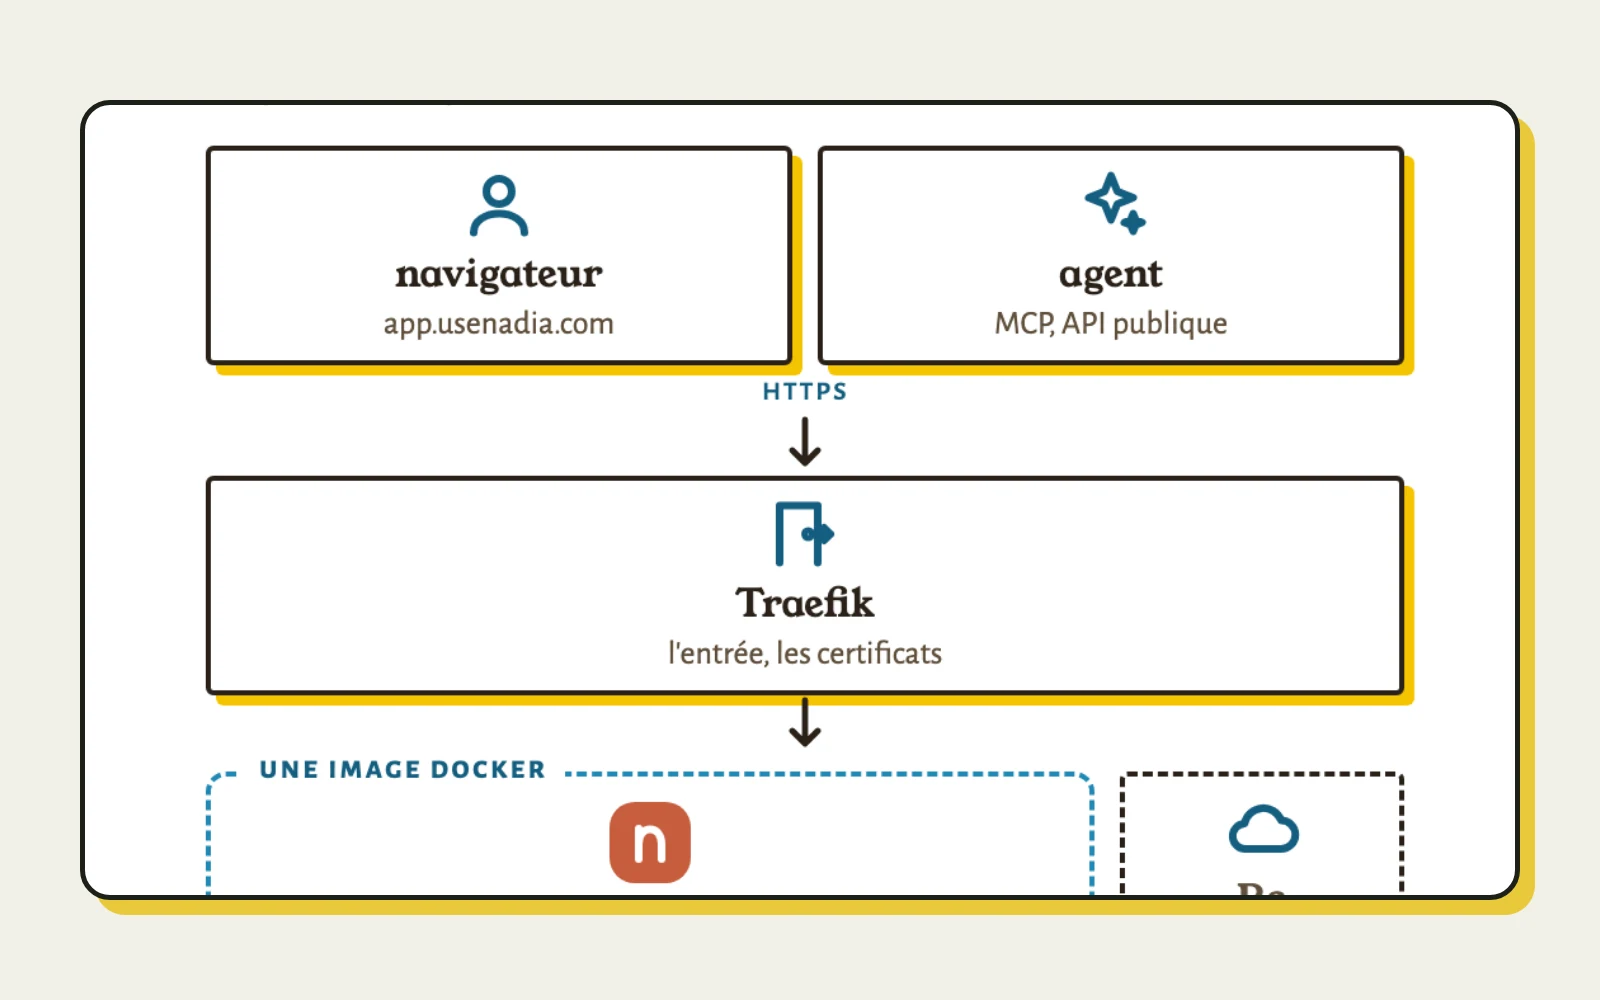
Hier après-midi, huit conteneurs tournaient dessus : Nadia, Postgres, Redis, Temporal avec son Postgres et son Elasticsearch, Traefik qui fait entrer le trafic, et un petit agent de monitoring. Il reste de la place.
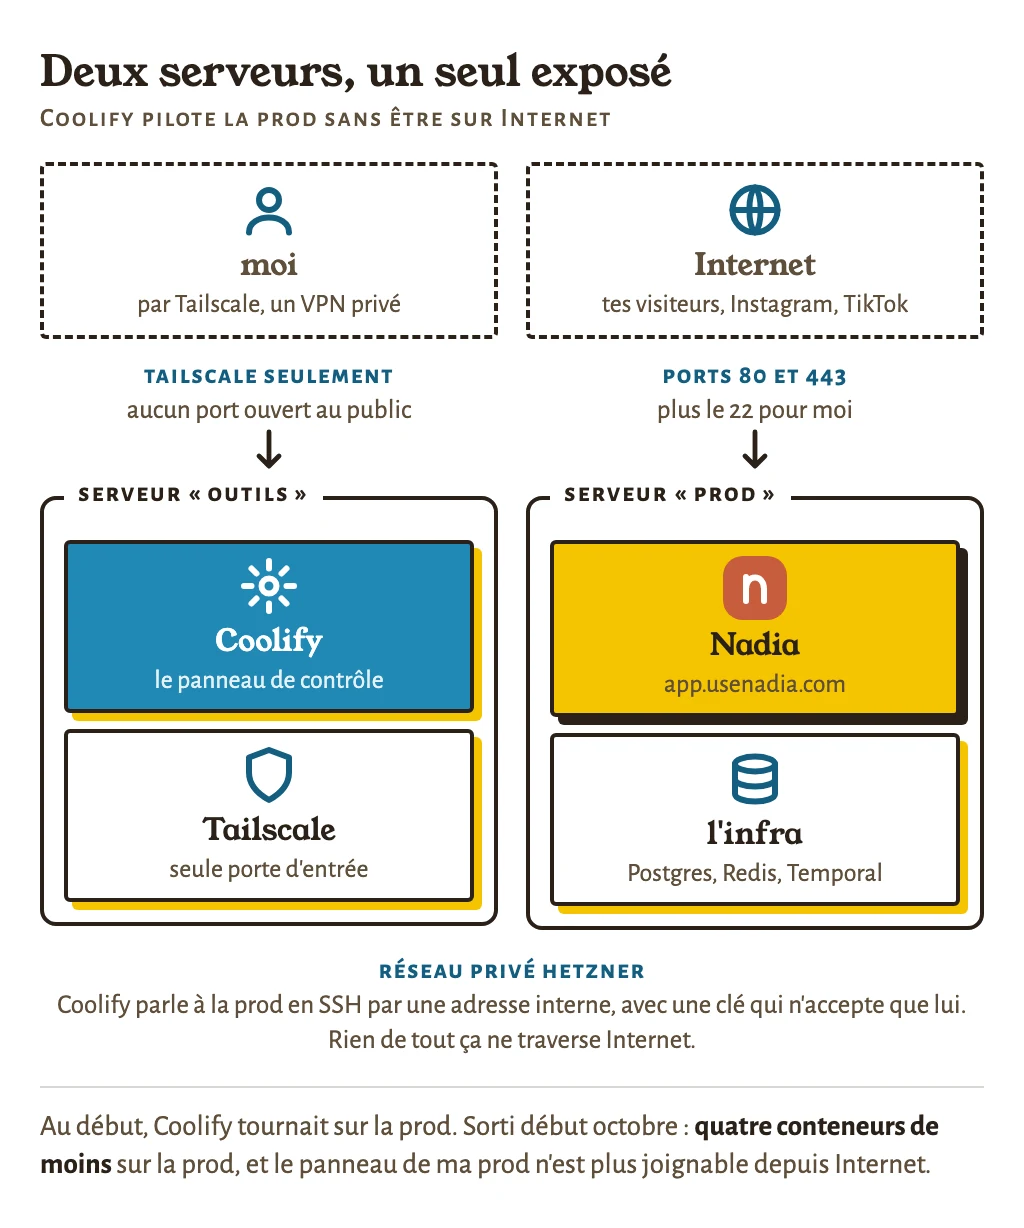
Il y a un deuxième serveur, « outils », qui n’héberge rien que tu verras. C’est là que vit Coolify.
Le déploiement
Coolify, c’est un panneau de contrôle open source qui fait ce que Heroku ou Vercel font pour toi : il lit un docker-compose dans ton repo, lance les conteneurs, pose les certificats HTTPS, et redéploie quand tu lui demandes.
Au début, il tournait sur le même serveur que Nadia. Je l’ai sorti début octobre : quatre conteneurs de moins sur la prod, et le panneau de contrôle de ma prod n’a aucune raison d’être exposé sur Internet. Aujourd’hui il tourne sur « outils », joignable seulement par Tailscale, un VPN privé entre mes machines, et il pilote la prod par le réseau privé de Hetzner.
Le chemin d’un déploiement :
- Je merge sur
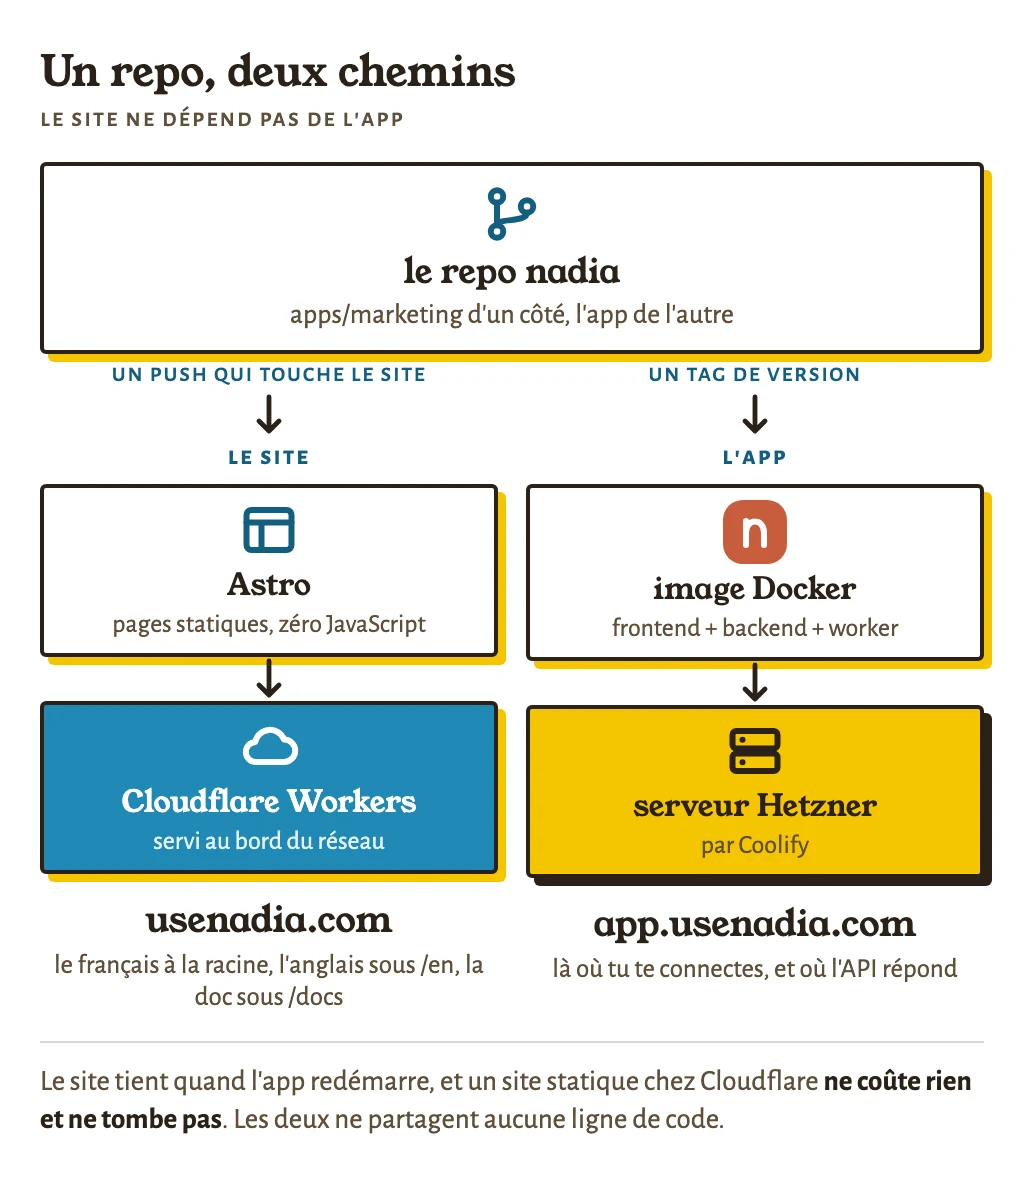
main. Il ne se passe rien, un push ne déploie pas. pnpm releasepose un tag de version, du typev2026.10.26.- Le tag réveille GitHub Actions, qui construit l’image Docker en neuf minutes et la pousse sur le registre de GitHub.
- Coolify fait tirer la nouvelle image par le serveur et redémarre Nadia. 34 secondes de 502, puis c’est en ligne.
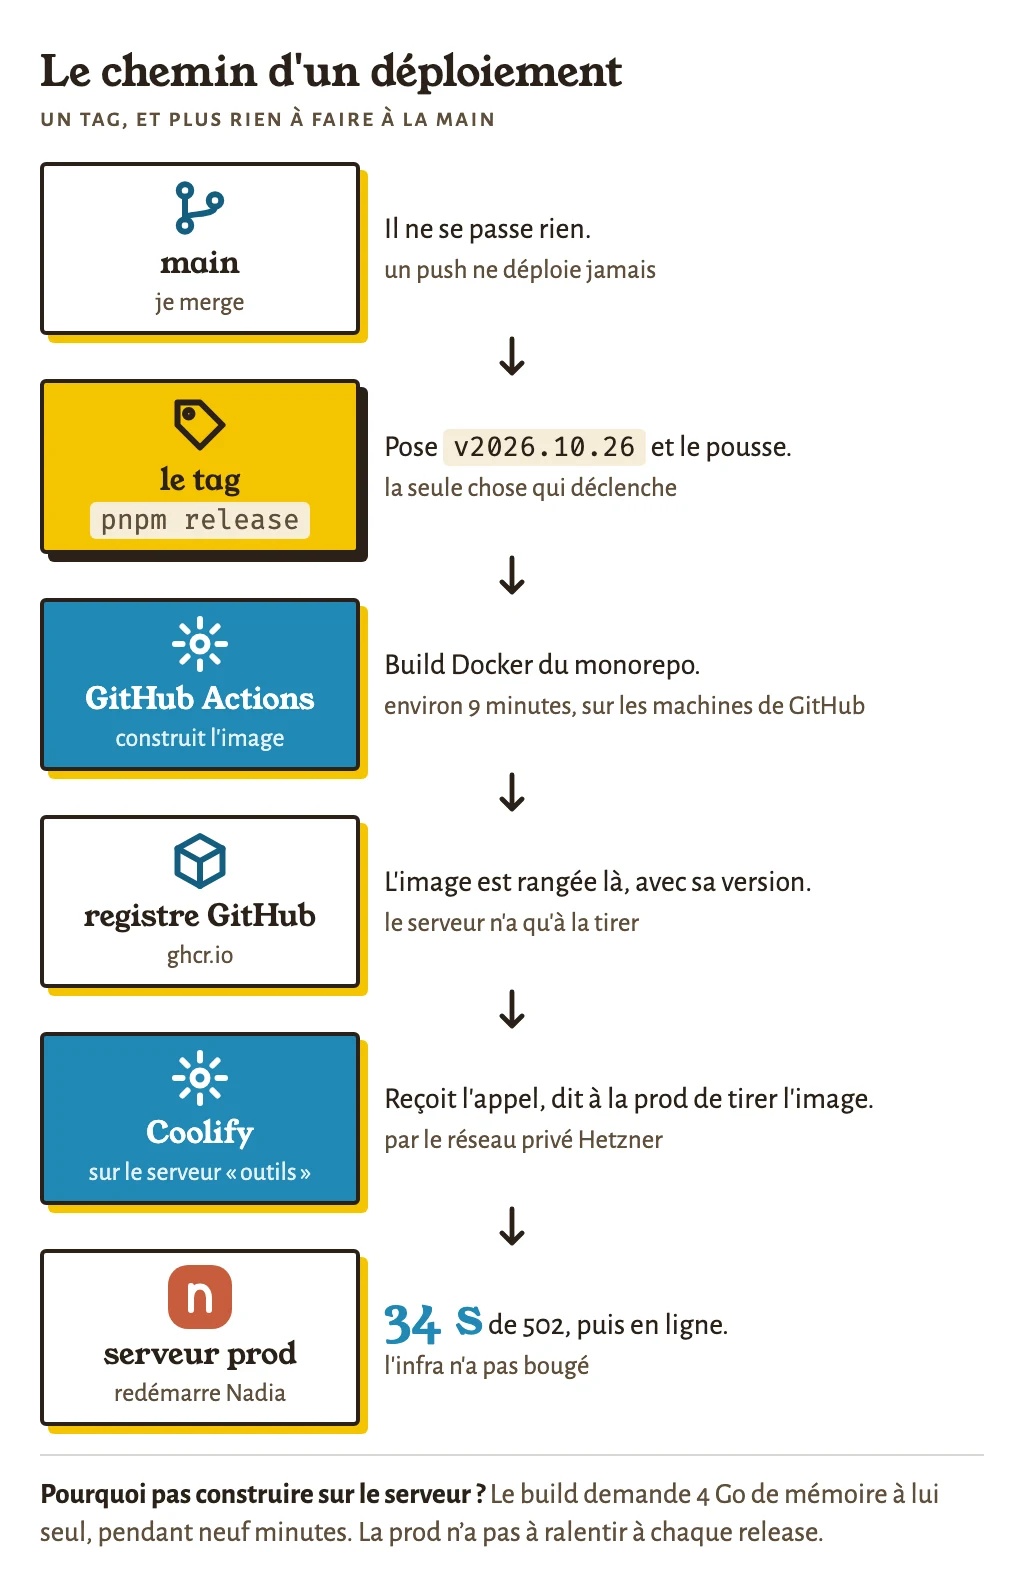
Pourquoi construire chez GitHub et pas sur le serveur ? Parce que le build demande 4 Go de mémoire à lui seul, pendant neuf minutes, et que la prod n’a pas à ralentir à chaque release. Règle absolue : le serveur ne construit jamais, il tire une image toute faite.
Deux leçons que j’ai payées :
Les minutes GitHub Actions. En septembre, chaque push lançait le build complet, et chaque merge reconstruisait l’image. C’est le problème du mode agentique : des sessions Claude Code poussent des commits à la pelle, chaque commit réveille la CI, et la facture suit. Mesuré : 4 000 minutes par mois, au-dessus des 3 000 de mon abonnement. Depuis le 24 septembre, seul le tag déclenche. Dix merges entre deux releases, c’est un build au lieu de dix.
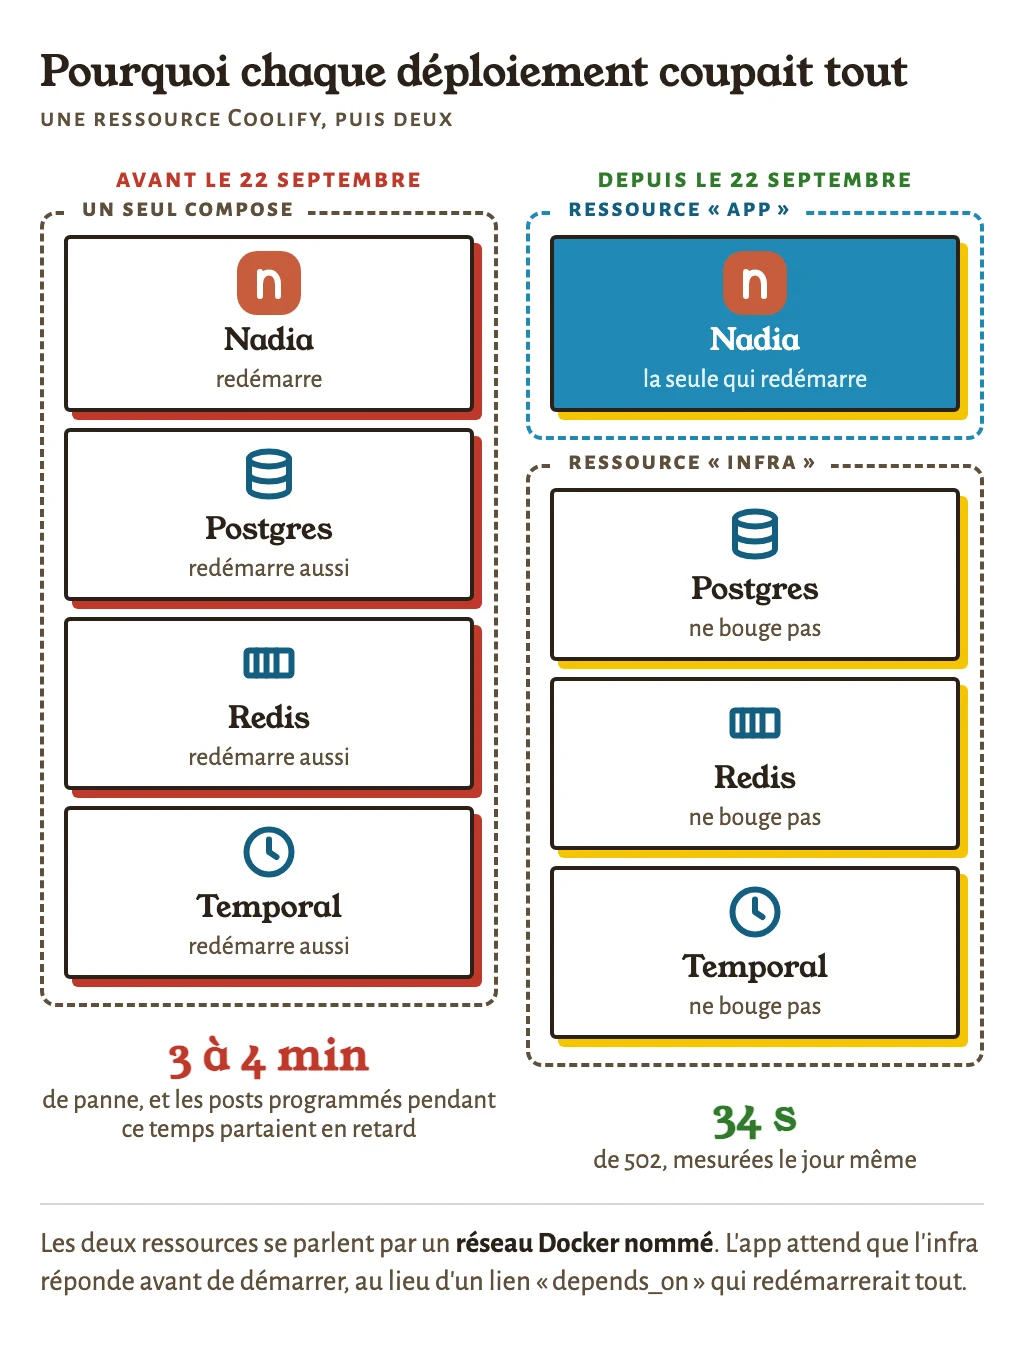
Le redéploiement qui coupait tout. Un seul docker-compose portait l’app et la base. Chaque déploiement redémarrait donc Postgres, Redis et Temporal avec l’app : trois à quatre minutes de panne, et les posts programmés pendant ce temps-là partaient en retard. Le 22 septembre, j’ai coupé en deux : une ressource « infra » que je ne redéploie jamais, et une ressource « app » avec la seule image Nadia. Mesuré le jour même : 34 secondes au lieu de trois minutes.
Les données, et ce qui a failli tout casser
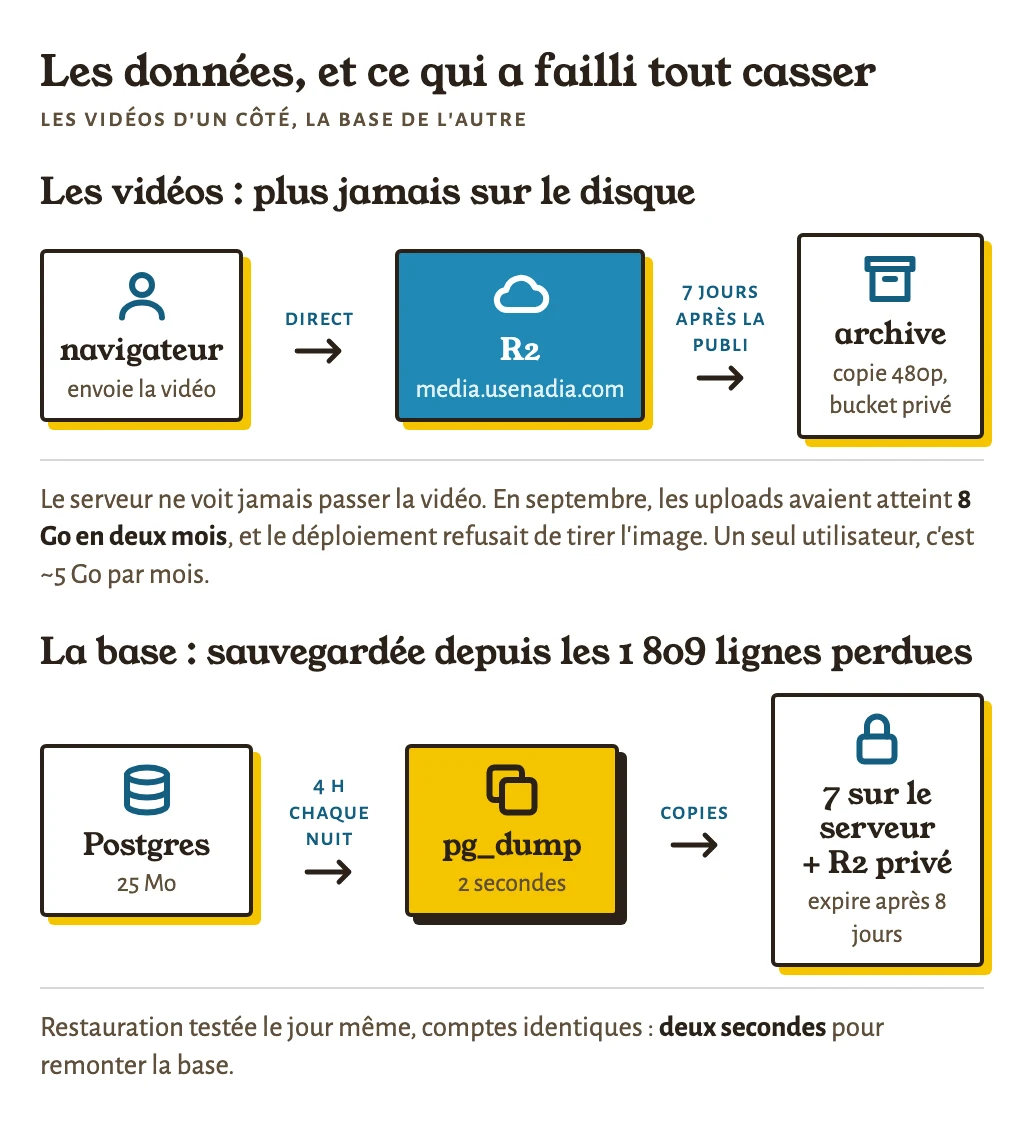
Les vidéos. Au départ, elles étaient stockées sur le disque du serveur. En septembre, les uploads prenaient déjà 8 Go, et le déploiement a commencé à refuser de tirer l’image, faute de place. Un seul utilisateur, c’est à peu près 5 Go de vidéo par mois. Le 21 septembre, j’ai tout basculé sur Cloudflare R2, un stockage d’objets compatible S3 : le navigateur envoie les gros fichiers directement chez Cloudflare, sans passer par mon serveur. Et un workflow de nuit supprime les vidéos sept jours après leur publication, après en avoir gardé une copie 480p. Les plateformes ont la vidéo, je n’ai pas besoin de la garder en 4K.
La base. Le 27 septembre, pour l’audit TikTok, j’ai dû supprimer mon compte TikTok de Nadia et le reconnecter. Ce que je n’avais pas en tête, c’est que supprimer un canal efface tout ce qui va avec, pour de bon, comme la loi le demande : 1 809 exécutions d’automatisations sont parties avec. Au moins, je sais que ça marche 😂 Il n’y avait aucune sauvegarde. Le lendemain, j’ai posé un pg_dump tous les matins à 4 h, sept copies sur le serveur et une copie dans un bucket R2 privé. Restauration testée le jour même : deux secondes pour une base de 25 Mo.
Le site marketing
Le site usenadia.com n’a rien à voir avec l’app : un site statique en Astro, zéro JavaScript côté visiteur, déployé sur Cloudflare Workers à chaque push qui le touche. Le français à la racine, l’anglais sous /en, la doc sous /docs, écrite à la main. Pourquoi le séparer de l’app ? Parce que le site doit tenir quand l’app redémarre, et qu’un site statique chez Cloudflare ne coûte rien et ne tombe pas.
Les erreurs que je ne referai pas
- Des secrets dans le repo. Jusqu’au 22 octobre, le docker-compose portait les vraies valeurs des clés. Le repo est privé, mais c’est privé jusqu’au jour où ça ne l’est plus. Un audit de sécurité les a sortis, et j’ai tout fait tourner le soir même. Aujourd’hui le compose ne contient que des
${VAR}, les valeurs vivent dans Coolify. - Une migration de base dans le mauvais ordre. Hier, j’ai renommé les offres dans la base, et j’ai déployé l’image avant de passer le script SQL. L’app a redémarré en boucle pendant huit minutes. La règle est maintenant écrite dans ma skill de déploiement : le script SQL avant le tag, jamais après.
Où j’en suis, pour de vrai
Les prix sont posés depuis vendredi : Solo à 29 € par mois pour 5 comptes, Équipe à 49 € pour 15, Agence à 99 € pour 50. Le prix dépend du nombre de comptes connectés, et de rien d’autre : pas de compteur de DM, pas de compteur de contacts, l’agent et l’API sont dans toutes les offres. Ce sont des prix largement sous le marché, parce que je cherche mes premiers clients, pas ma marge. Et il y a un code de pré-lancement, valable une semaine, jusqu’au mardi 3 novembre, et qui te garde le prix à vie : Solo à 19 € au lieu de 29, Équipe à 29 € au lieu de 49. Je ne le mets pas dans ce mail : si ça t’intéresse, réponds-moi, je te le donne.
Le paiement passe par Stripe depuis hier, et l’inscription est ouverte : tu crées ton compte, tu choisis une offre, et les sept premiers jours sont à 0 €, carte demandée, résiliable avant le premier prélèvement. Une chose à savoir : sur TikTok, la publication publique attend encore un dernier audit de leur part. En attendant, un post TikTok programmé arrive en brouillon dans ton app TikTok, et tu le publies en un clic. Instagram, lui, est complet. Facebook, LinkedIn, X et Threads viendront ensuite.
Et un petit scoop, puisque tu es arrivé jusqu’ici. Mon prochain challenge, à la fin des 100 jours, ce sera de construire ce SaaS en public : trouver ses clients, le vendre, le montrer. Je continuerai à donner des exemples et des skills concrets de ce que je fais tous les jours, mais mes prochaines vidéos seront moitié là-dessus, moitié éducatives, sur Nadia. Tu le verras naître ici en premier.
Si tu veux voir à quoi ressemble un SaaS avant ses premiers clients, c’est maintenant. Et si tu le testes, dis-moi ce qui coince, c’est exactement ce dont j’ai besoin.
Les liens
- Nadia : le site, la doc, brancher Claude par MCP, l’API publique, la ligne de commande.
- L’hébergement : Hetzner Cloud, le serveur. Coolify, le déploiement. Tailscale, le VPN entre mes machines. Traefik, l’entrée HTTPS.
- Le build : GitHub Actions et le registre de conteneurs GitHub.
- Le code : Next.js, NestJS, Temporal, Prisma, Postgres.
- Les données : Cloudflare R2 pour les vidéos, Cloudflare Workers et Astro pour le site.
Si tu es arrivé jusqu’ici, réponds-moi juste « lu », ça me dit si le format long vaut le coup. Et si tu as une question sur une pièce en particulier, le worker, Coolify, les backups, pose-la : les prochains numéros peuvent creuser une pièce à la fois.
À mardi prochain, Vincent
Le prochain, dans ta boîte
Un mail par semaine, le mardi.
Désinscription en un clic sur chaque mail. Je hais le spam.